| 지표 | 수치 | 출처 |
|---|---|---|
| LoCoMo류 벤치마크 포화 모델의 다중 세션 과제 성적 | 40~60% | MemoryArena 2026 |
| MemoryArena가 다루는 과제 갈래 | 4종 | MemoryArena 2026 |
| 2026년 메모리 평가를 주제로 삼은 벤치마크 | 2건 이상 | ICML·ICLR 2026 |
| 주요 모델의 맥락 창 | 100만 토큰 | Google 2026-02 |
1. 벤치마크가 재는 것과 재지 않는 것
에이전트에게 기억을 붙이는 일은 이제 어렵지 않다. 대화를 저장하고, 요약하고, 필요할 때 꺼내는 도구가 여럿 나와 있다. 문제는 그다음이다. 그 기억이 제대로 작동하는지 어떻게 아는가.
지금까지는 벤치마크로 확인했다. 대표적인 것이 LoCoMo류의 장문 대화 평가다. 오래된 대화에서 특정 사실을 찾아내는지 묻는다. 여러 모델이 이 시험을 거의 만점으로 통과했다.
2026년에 나온 MemoryArena는 다른 질문을 던진다[1]. 대화에서 사실을 찾는 대신, 여러 날에 걸쳐 이어지는 과제를 준다. 웹을 돌아다니며 정보를 모은다. 앞서 받은 제약 조건을 지키며 계획을 세운다. 단계마다 앞 단계의 결과를 써야 한다[1].
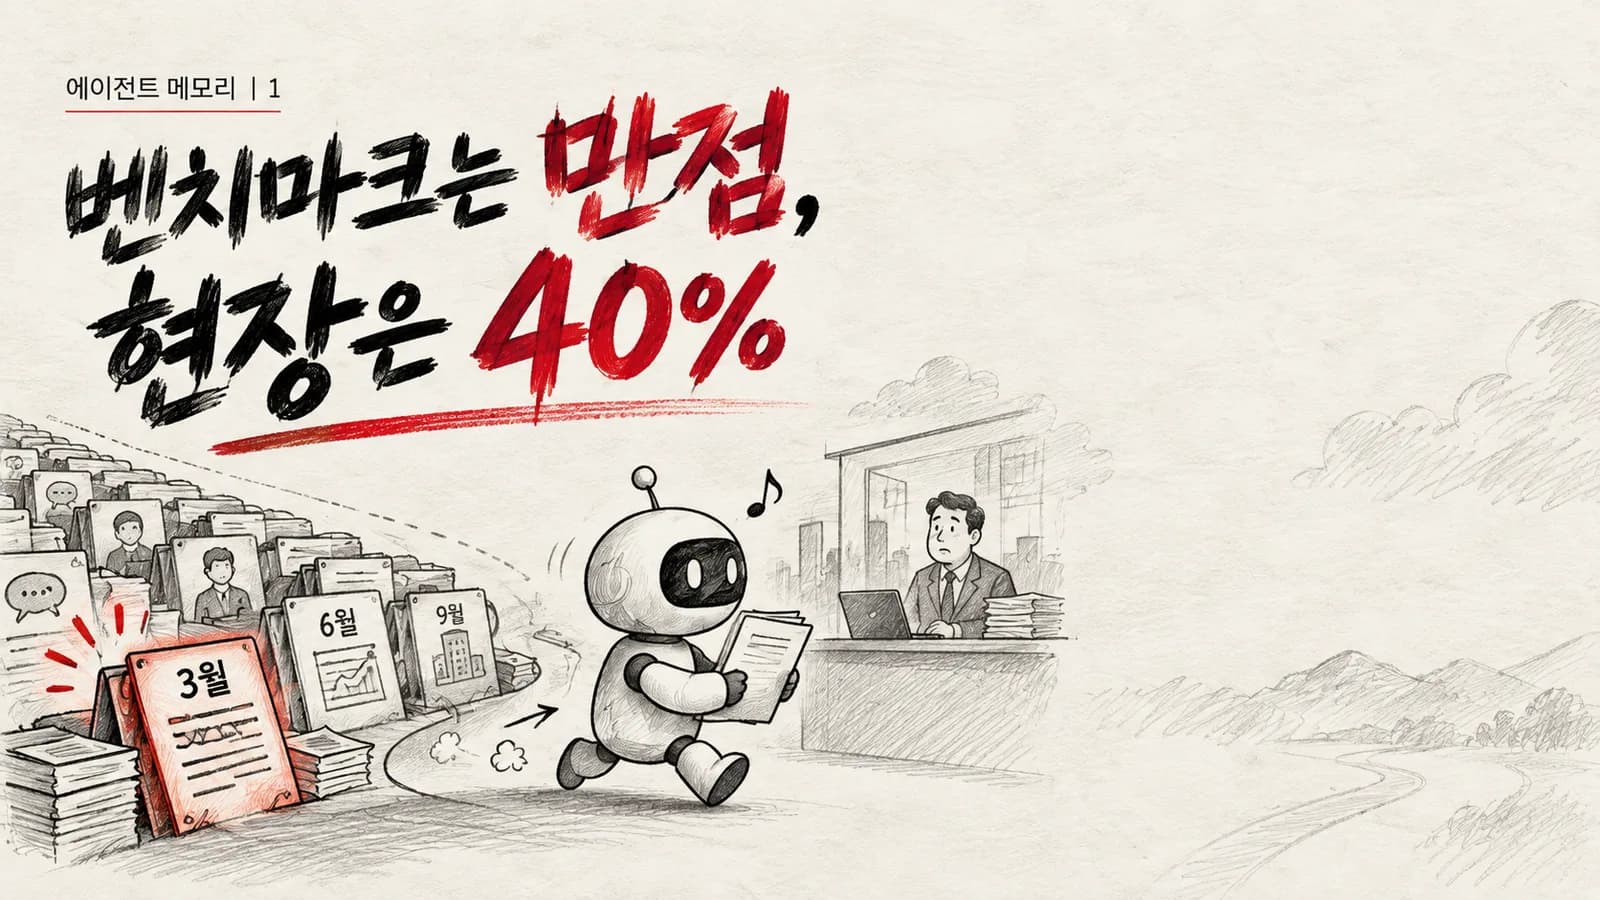
결과가 갈렸다. 기존 벤치마크를 거의 푼 에이전트가 이 환경에서 40~60%에 머물렀다[1].
같은 기억 능력을 재는데 왜 점수가 다른가. 재는 대상이 달라서다.
기존 벤치마크   질문이 오면 답을 찾아낼 수 있는가        — 회수 능력
MemoryArena    지금 무엇을 꺼내야 하는지 스스로 아는가   — 판단 능력
앞의 시험에서는 무엇을 찾아야 하는지 질문이 알려준다. 뒤의 시험에서는 알려주지 않는다. 에이전트가 정해야 한다.
2. 그래서 메모리는 저장 문제가 아니다
이 차이를 알면 문제의 위치가 옮겨간다.
업계는 메모리를 검색의 연장으로 다뤄왔다. 잘 쪼개고, 잘 심고, 잘 찾는 문제로 본 것이다. 실제로 그쪽 개선은 계속 나온다. 단일 패스로 계층을 뽑아내고 여러 신호로 검색해 토큰을 아끼는 방법이 보고됐다[5].
그러나 저장을 아무리 잘해도 부르지 않으면 소용이 없다. 반대로 필요 없는 기억을 부르면 방해가 된다. 판단이 빠진 자리를 저장 기술로 메울 수 없다.
메모리를 다룬 2026년 서베이도 메커니즘과 평가를 나란히 놓는다[3]. 저장 구조만 다루던 정리에서 한 칸 옮겨온 것이다.
한 가지 관찰이 더 있다. 평가 기간을 길게 늘리면 메모리 구조의 순위가 뒤집힌다[4]. 짧은 시험에서 앞선 구조가 오래 돌리면 뒤로 간다. 구조에 절대 우열이 없고 운영 기간에 따라 답이 달라진다는 뜻이다.
정리하면 이렇다. 메모리의 성능은 구조가 아니라 운영 조건에 달려 있다. 그런데 지금 벤치마크는 운영 조건을 담지 못한다.
3. 판단은 어디에 놓이는가
메모리를 설계할 때 보통 세 층으로 나눈다.
단기    지금 대화에서 오간 내용
장기    반복해서 확인된 사실. 고객 단가 조건, 결재선, 금지 품목
에피소드 한 번 있었던 사건. 8월에 납기가 밀렸고 그때 이렇게 처리했다
이 구분 자체는 오래됐고 유용하다. 그런데 구분만으로는 판단이 생기지 않는다. 세 층을 다 갖춰도 언제 어느 층을 열지는 따로 정해야 한다.
판단이 놓이는 자리는 셋이다.
쓰기 시점   무엇을 장기로 올릴 것인가. 한 번 나온 말은 사실이 아니다
호출 시점   지금 들어온 요청이 옛 기억을 필요로 하는가
버리기 시점 더 이상 유효하지 않은 기억을 언제 내릴 것인가
세 자리 중 지금 가장 덜 다뤄지는 곳이 호출 시점이다. 쓰기와 버리기는 규칙으로 처리할 수 있다. 호출은 요청을 읽어야 정해진다.
견적 사례로 돌아가면 이렇다. 9월 요청문에는 3월 조건을 부르라는 말이 없다. 고객사 이름과 품목이 같다는 것만 있다. 그 둘을 보고 옛 조건을 열어야 한다고 판단하는 일, 그것이 호출 시점의 판단이다.
여기서 조직마다 답이 갈린다. 같은 품목이라도 단가 조건을 이어받는 회사가 있고 매번 새로 매기는 회사가 있다. 그래서 이 판단은 모델이 일반 지식으로 가질 수 없다. 조직의 규칙이다.
4. 한국 기업이라면 어떻게 겪는가
실제 사례가 아니라 가정이다. 중견 제조기업이 견적 대응 에이전트를 들인다고 생각해보자.
고객사가 3월에 단가 조건을 하나 걸었다. 6월에 다른 담당자가 비슷한 문의를 한다. 9월에 정식 견적을 요청한다. 세 번의 대화는 각각 다른 세션이다.
이때 에이전트가 해야 할 일은 3월 조건을 찾아내는 것이 아니다. 9월 요청을 받은 순간 3월 조건을 확인해야 한다는 것을 스스로 아는 일이다. 질문에는 그 단서가 없다. 고객은 "지난번 조건"이라고 말하지 않는다.
여기서 무너지면 결과는 둘 중 하나다. 옛 조건을 놓쳐 잘못된 견적을 낸다. 아니면 관련 없는 옛 대화까지 끌어와 엉뚱한 답을 낸다. 둘 다 사람이 뒤늦게 발견한다.
도입 전에 이 장면을 시험해봤는가. 대개 아니다. 벤치마크 점수와 시연을 보고 골랐을 것이다. 시연은 한 세션 안에서 이뤄진다. 실패는 세션과 세션 사이에서 일어난다.
5. 반대편의 논리
여기에 반론이 있다. 맥락 창이 충분히 커졌으니 메모리를 따로 설계할 이유가 없다는 주장이다.
근거가 약하지 않다. 주요 모델이 100만 토큰을 다룬다[6]. 책 한 권 분량을 통째로 넣고 물어볼 수 있다. 중간 규모의 자료를 다루는 사내 도구라면 전부 넣는 편이 설계보다 싸고 빠르다.
이 반론은 조건부로 맞다. 다루는 자료가 맥락 창에 들어간다고 하자. 그리고 한 세션 안에서 일이 끝난다. 그러면 별도 메모리는 과한 설계다.
조건이 깨지는 지점은 둘이다. 자료가 창보다 클 때, 그리고 일이 여러 세션에 걸칠 때다. 제조기업 견적 사례가 뒤쪽이다. 3월과 9월 사이에 세션이 끊긴다. 창의 크기와 무관하다.
실무 쪽에는 다른 정리도 있다. 둘 중 하나를 고르지 말라는 것이다. 질의마다 맞는 쪽으로 보내는 구조가 낫다고 본다[7]. 이 정리를 따르면 질문은 다시 같은 자리로 돌아온다. 무엇을 기준으로 보낼 것인가. 그 기준이 곧 판단이다.
6. 그러면 무엇을 해야 하는가
순서를 바꾸는 것이 핵심이다.
흔한 순서   저장 구조 선택 → 구축 → 평가
권하는 순서 평가 과제 정의 → 저장 구조 선택 → 구축
평가 과제를 먼저 만든다. 만드는 방법은 어렵지 않다. 자사 업무에서 기억이 깨졌던 장면을 모으면 된다. 앞의 견적 사례처럼 세션이 끊기고 시간이 벌어진 장면이다.
과제를 만들 때 세 가지를 넣는다.
1  단서를 주지 않는다      "지난번 조건대로"라고 알려주지 않는다
2  세션을 끊는다           한 대화 안에서 끝나지 않게 한다
3  방해 기억을 섞는다       불러오면 안 되는 옛 기록을 함께 쌓아둔다
3번이 빠지면 시험이 쉬워진다. 필요한 기억만 들어 있으면 아무거나 불러도 맞는다.
그다음 저장 구조를 고른다. 이때 기준은 벤치마크 점수가 아니라 위에서 만든 과제의 통과율이다. 구조의 순위는 운영 기간에 따라 바뀐다[4]. 그러니 한 번 재고 끝내면 안 된다. 운영하면서 같은 과제를 다시 돌려야 한다.
평가 자체를 다룬 벤치마크가 2026년에 둘 이상 나왔다[1][2]. 그만큼 아직 표준이 없다는 뜻이기도 하다. 남이 만든 시험을 기다릴 이유가 없다. 자사 업무로 만든 시험이 먼저다.
JK's Take
메모리 제품을 고르는 일이 아니라, 자사 업무에서 기억이 깨지는 장면을 목록으로 만드는 일이 먼저다.
에이전트를 여덟 개 만들면서 반복해서 겪은 것이 있다. 시연에서 잘 돌던 것이 운영에서 무너지는 지점은 대개 기능이 아니라 이음매다. 세션과 세션 사이, 담당자와 담당자 사이, 어제와 오늘 사이다.
메모리는 그 이음매를 메우라고 붙이는 장치다. 그런데 지금 시장은 메모리를 저장소로 팔고, 저장소의 성능으로 비교한다. 이음매가 잘 메워졌는지는 아무도 재지 않는다.
재지 못하는 것은 개선하지 못한다. 그래서 순서가 중요하다. 무엇을 살지 정하기 전에 무엇을 잴지 정해야 한다.
What to Watch
— 메모리 평가 표준이 하나로 모이는지 보라. 2026년에 평가를 주제로 한 벤치마크가 둘 이상 나왔다[1][2]. 표준이 서면 제품 비교가 가능해지고, 서지 않으면 각자 만든 시험으로 각자 고르게 된다.
— 평가 기간에 따라 구조 순위가 뒤집힌다는 관찰[4]이 다른 연구에서도 재현되는지 추적하라. 재현되면 "조직에 맞는 메모리 구조"라는 질문 자체가 "얼마나 오래 돌릴 것인가"로 바뀐다.
— 맥락 창 확대와 메모리 설계가 어디서 갈라지는지 지켜보라. 창이 커질수록 단일 세션 업무는 설계가 필요 없어진다. 남는 것은 세션이 끊기는 업무다. 그 경계가 어디인지가 도입 판단의 기준이 된다.
References
[1] (A) MemoryArena, "Benchmarking Agent Memory in Interdependent Multi-Session Agentic Tasks", ICML, 2026. https://memoryarena.github.io/ — 웹 탐색, 제약 조건 계획, 점진적 정보 탐색, 순차 형식 추론 네 갈래로 상호의존적 다중 세션 과제를 구성한다. LoCoMo 등 기존 장문 대화 벤치마크에서 포화에 가까운 성적을 낸 에이전트가 이 환경에서 40~60%에 머물렀다.
[2] (A) "Evaluating Memory in LLM Agents via Incremental Multi-Turn Interactions", MemoryAgentBench, ICLR, 2026. https://arxiv.org/pdf/2507.05257 — 증분적 다중 턴 상호작용으로 에이전트 메모리를 평가하는 벤치마크다.
[3] (A) "Memory for Autonomous LLM Agents: Mechanisms, Evaluation, and Emerging Frontiers", arXiv, 2026. https://arxiv.org/html/2603.07670v1 — 메모리 메커니즘과 평가를 함께 정리한 서베이다.
[4] (A) "Ground Truth First: A Longitudinal Evaluation Instrument for Agent Memory, and the Tenure Crossover in Memory-Architecture Rankings", arXiv, 2026. https://arxiv.org/pdf/2607.21962 — 평가 기간을 늘리면 메모리 아키텍처의 순위가 뒤바뀐다는 관찰을 보고한다.
[5] (B) Mem0, "State of AI Agent Memory 2026", Mem0, 2026. https://mem0.ai/blog/state-of-ai-agent-memory-2026 — 2026년 4월 단일 패스 계층 추출과 다중 신호 검색을 쓰는 토큰 효율 메모리 알고리즘을 공개했다. 벤더 기술 블로그이며 실측치를 포함한다.
[6] (A) Google, "Gemini 3.1 Pro: A smarter model for your most complex tasks", Google Blog, 2026-02-19. https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-1-pro/ — 100만 토큰 맥락 창을 지원한다.
[7] (C) "Long-Context Models vs. RAG: When the 1M-Token Window Is the Wrong Tool", TianPan.co, 2026-04. https://tianpan.co/blog/2026-04-09-long-context-vs-rag-production-decision-framework — 긴 맥락과 검색 중 질의마다 맞는 쪽으로 보내는 라우터 구조를 제안한다. 실무자 블로그이며 인용된 비용·지연 수치는 원 출처를 확인하지 못했다. 본문에서는 구조 제안만 인용했다.